
MATLAB Agentic Toolkit で実現する組み込み AI ― 学習から実装・検証まで
※この投稿は 2026 年 11 月 3 日に Artificial Intelligence へ 投稿されたものの抄訳です。
—
ゲストブロガー:Arkadiy Turevskiy
Arkadiy は MathWorks で AI および制御関連製品のプロダクトマネージャーを務めています。MathWorks には20年以上在籍しています。MathWorks に入社する前は、Pratt & Whitney で航空機エンジンの制御システムを設計していました。
組み込み AI アプリケーションの開発には、データの準備、ネットワークの学習、必要なメモリ量の削減、生成コードの検証が含まれます。それぞれのステップでは、精度、リソースの制約、実装時の動作について、エンジニアとしての判断が求められます。そこで今回、再利用可能なエンジニアリングの指針を活用することで、判断には自分も関与しながら、コーディングエージェントがこのワークフローの実行をどのように支援できるかを探りたいと考えました。
本投稿の検証では、Arm Cortex-M7 プロセッサ向けのバッテリー充電状態(SOC)推定器を取り上げます。 元のネットワークに対する二乗平均平方根誤差(RMSE)の増加を5%以内に抑えながら、ネットワークの重みとバイアスの保存容量を最小限にすることを試みてみます。
充電状態推定の例のバッテリーデータを使い、コーディングエージェントに MATLAB Agentic Toolkit の matlab-deploy-embedded-ai スキルを使用するよう依頼します。 目的は温度、電圧、電流の測定値からバッテリーの充電状態を推定する仮想センサーを学習させ、Simulink に統合し、実装用の C コードを生成することです。
ベストプラクティスをコードとともにまとめる
大規模言語モデルは膨大なソースコードを学習しているため、コーディングエージェントはディープラーニングの学習スクリプトをすばやく作成できます。一方でエンジニアリングの実務自体を公開データから学ぶのは困難です。その知識は多くの場合、組織の標準、プロジェクトのレビュー、そして経験の中に蓄積されています。またその知識はエンジニアの頭の中にあるかもしれませんが、毎回のプロンプトにすべて書き込むのは現実的ではありません。
ただ、スキルファイルを使えばその指針を再現できます。スキルはエンジニアが内容を確認できる、読みやすくバージョン管理された Markdown としてベストプラクティスをまとめたものです。通常、エージェントはプロンプトに応じて関連するスキルを呼び出しますが、私の経験では正しく呼び出せないケースもありました。確実に使用させるにはスキル名を明示します。Codex では、$matlab-deploy-embedded-ai と入力するか、matlab-deploy-embedded-ai を使うようエージェントに伝えます。
Embedded AI スキルは、推奨関数、検証手順、レビューのチェックポイントを含む、エージェントが従うべきワークフローを提供します。たとえば trainnet でニューラルネットワークを学習させた後、人がレビューできるように、学習済みネットワークを Deep Network Designer で開くようエージェントに指示します。
学習後のステップはモデルの圧縮です。予測精度への影響を評価しながら、ネットワークの重みとバイアスに必要な容量を削減します。このスキルでは、MATLAB 上のネットワーク、Simulink での実装、生成コードの間で数値結果を比較することも求めています。各チェックポイントで、エージェントはスクリプトを保存し、先に進む前に私がレビューできるよう結果を提示します。MATLAB Agentic Toolkit と Simulink Agentic Toolkit により、エージェントは実行中の MATLAB セッションに接続し、スクリプトの実行、モデルのシミュレーション、結果の報告を行います。
各ステップをレビューすることで、誤った方向に進んでも、その影響が広がる前に修正できます。
要件に基づいてモデルを選ぶ
今回のバッテリーデータは、−10、0、10、25 °C の各温度を対象としています。MATLAB の充電状態推定の例にあるデータ準備手順に従い、データを500ステップのシーケンスに分割し、学習用と検証用に70対30の比率で分け、学習用201シーケンス、検証用87シーケンスが得られました。この例で別途用意されているテストデータからは、288のテストシーケンスが得られました。ベースラインのネットワークには463,489個の学習可能なパラメーターがあり、独立したテストセットで RMSE は0.034258でした。
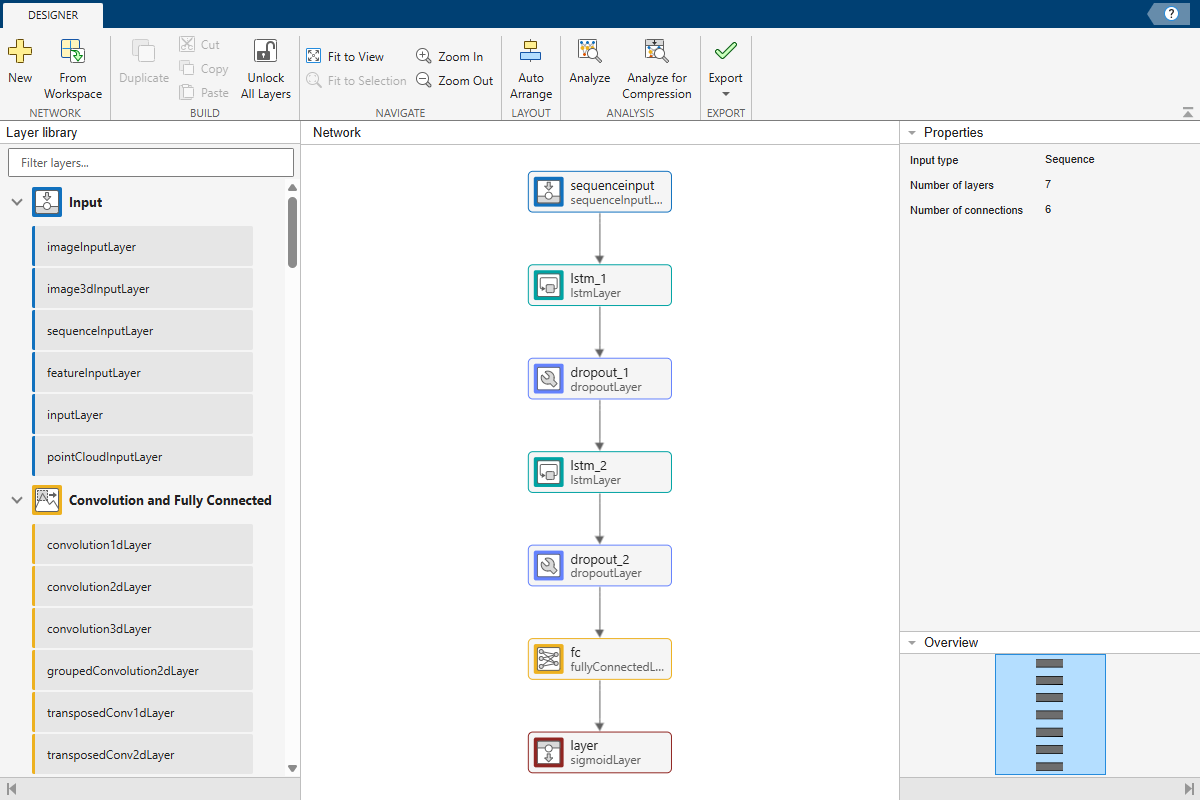
Figure 1: エージェントは、圧縮前にレビューできるよう、学習済みのバッテリー充電状態推定ネットワークを Deep Network Designer で開きました。
学習後、リソースに制約のあるマイクロコントローラー向けにモデルを圧縮します。精度とパラメーターの保存容量を比較するために、パレートフロントを用いました。射影と量子化は、それぞれ単独でも併用でもパラメーターの保存容量を削減できますが、精度とのトレードオフは異なります。
圧縮手法は、ネットワークのアーキテクチャに適したものである必要があります。このネットワークでは、長短期記憶(LSTM)層のパラメーター数を減らす射影と、低精度の数値を使う量子化を比較しました。それぞれの手法を単独で適用した場合と、併用した場合を評価しました。
元のモデル(ベースライン)に対する RMSE の増加は、5%以内を許容範囲としました。エージェントは、学習用の全201シーケンスで量子化候補のキャリブレーションを行い、圧縮した3つの候補を、学習に使わずに取り置いた同じ32シーケンスで評価しました。データの違いをモデル性能の違いと取り違えないよう共通の比較セットとしています。
ここでいうパラメーターの保存容量とは、estimateNetworkMetrics が学習可能な重みとバイアスについて報告するメモリ量です。これはフラッシュメモリまたは ROM の使用量の目安であり、生成コード、ネットワークの状態、活性化、実行時の SRAM は含みません。
| 候補 | パラメーターの保存容量 | RMSE の変化 | 5%の許容範囲 |
|---|---|---|---|
| ベースラインの float32 | 1.768 MB | 基準値 | Pass |
| 射影を適用した float32 | 0.0464 MB | +1.64% | Pass |
| 量子化したベースライン | 0.4464 MB | −3.94% | Pass |
| 射影と量子化を適用 | 0.0160 MB | −0.62% | Pass |
Table 1: 同じ32シーケンスの比較セットで測定した結果。RMSE の変化は、そのセットでのベースラインに対する相対値で、負の値は RMSE が低下したことを示します。
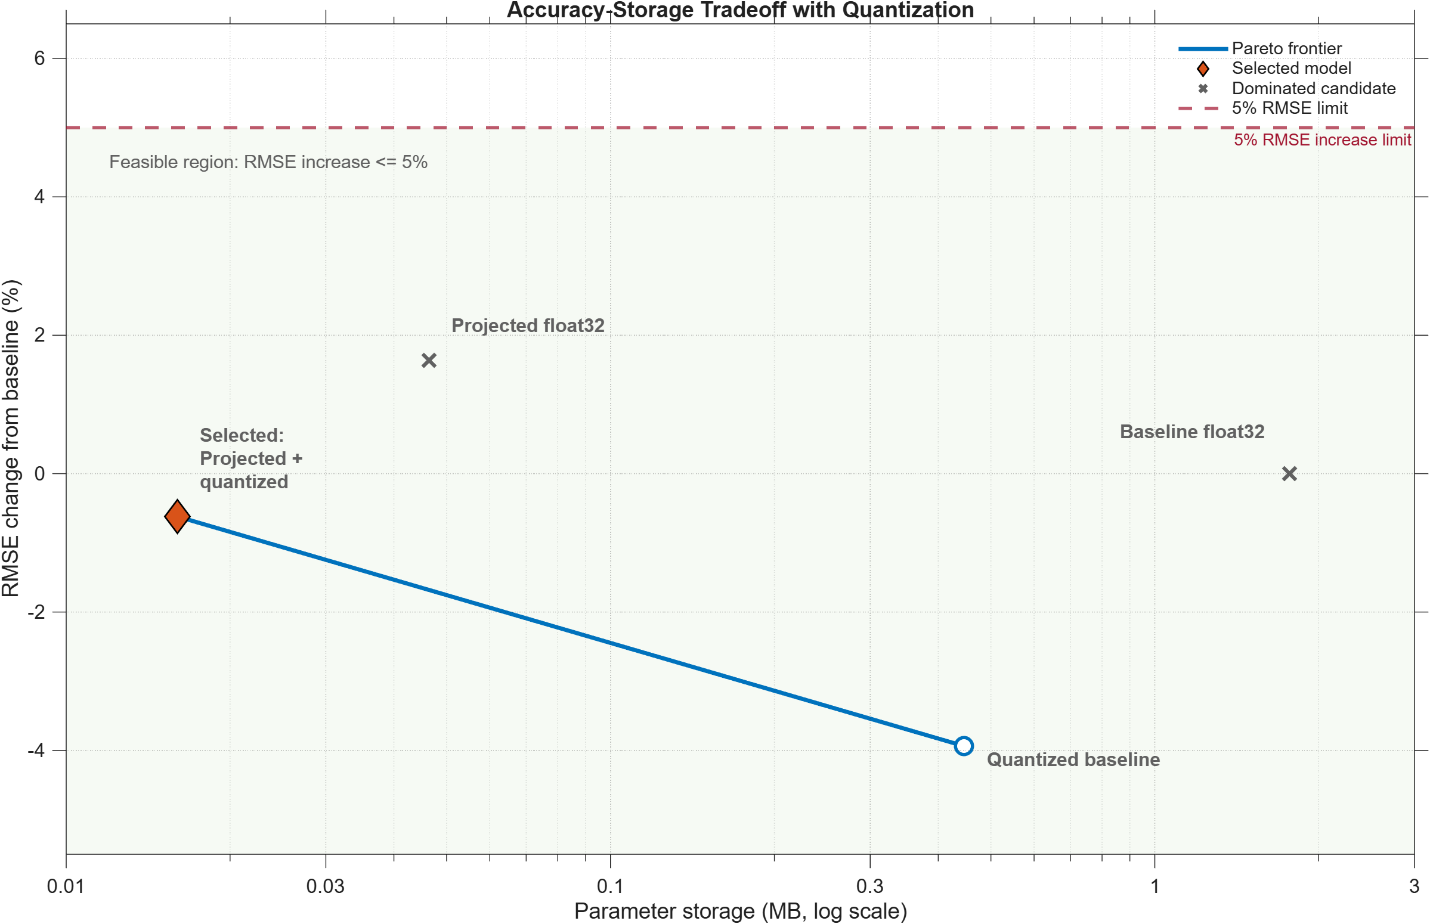
Figure 2: 4つの候補の実測値に基づくパレートフロント。
射影と量子化を適用したモデルのパラメーター保存容量は0.0160 MBで、float32 と比べて99.10%削減できました。RMSE は、32シーケンスの比較セットで0.62%、検証セット全体では8.69%低くなりました。許容範囲内で最小の候補として、このモデルを選びます。
エージェント:射影と量子化を適用したモデルが、RMSE の増加率5%という許容範囲内で最小です。また、比較セットでの RMSE は、ベースラインより0.62%低くなっています。次は、Simulink への統合と数値的等価性のテストです。進めてもよいですか?
エンジニア: はい。ただし、まず量子化したモデルの RMSE が低くなる理由を説明してください。
エージェント: 量子化では、低精度で表現できる最も近い値に数値を丸めます。このデータセットでは、その変化によって予測値がたまたま目標値に近づきました。これは、このモデルとデータに固有の結果です。量子化によって一般に RMSE が低下するわけではありません。
エンジニア: わかりました。進めてください。
エージェント: Simulink の等価性テストに合格しました。次のステップは、コード生成とソフトウェアインザループ(SIL)テストです。進めてもよいですか?
エンジニア: 進めてください。
圧縮の影響と実装間の数値のずれを分けて評価する
圧縮するとモデルが変わるため、その受け入れテストでは、学習に使わずに取り置いたデータでアプリケーションの性能を測定します。上記の RMSE の比較が、これに当たります。実装のテストでは、別の点を確認します。承認済みモデルを MATLAB から Simulink、そして生成コードへ移したときに、等価な数値結果が得られるかどうかですね。
エージェントに、各温度で500ステップのシーケンスを1つずつ実行させ、各実装から2,000個の出力を得ました。これらのテストベクトルに対し、MATLAB 上の量子化ネットワーク、Simulink のノーマルモードのシミュレーション、ソフトウェアインザループ(SIL)シミュレーションは、ビット単位で一致する出力を生成しました。MAE、RMSE、最大誤差は、すべて厳密にゼロでした。これらのゼロという値は、実装間の数値のずれを測ったものであり、充電状態の実測値に対する予測誤差ではありません。
Arm Cortex-M 向けの構成で C コードの生成が完了し、生成されたソースコードでは固定整数型が使われていました。量子化を用いたワークフローでは、2番目の LSTM 層で固定小数点の飽和に関する警告が報告されました。 それでも、このテストでは実装間の数値のずれはなく、モデルの品質への影響は、取り置いたデータでの RMSE にすでに反映されていました。この警告については、より広範なテストが必要です。開発ボードもクロスコンパイラーもないため、フラッシュメモリ使用量、SRAM 使用量、実行時間は未測定のままです。エージェントは、その範囲を超える主張はしませんでした。
実績のあるツールで根拠を得る
これらの指標をエージェントがでっち上げたのではないか、と疑問に思うのはもっともです。エージェントがそれらを推測したわけではありません。エージェントはワークフローの実行を取りまとめ、MATLAB、Simulink、コード生成、検証が根拠を生み出しました。私は要件を定め、トレードオフをレビューし、重要な判断を承認しました。
スキルでは、現在の変数から指標を計算し、結果をハードコードしないようエージェントに指示しています。LLM は依然として非決定的であり、適格性認定も受けていません。ネットワーク、テストデータ、構成を固定すれば、コード生成とテストの実行は、再現可能な手順に従って行われます。適格性が認められたワークフローでは、その認定は、特定のツール、プロセス、プロジェクトの証拠に対するものです。その認定がコーディングエージェントにまで及ぶことはありません。
ワークフローを再利用可能にする
以前の投稿では、MATLAB Agent Skills Playground にある、このスキルの初期バージョンを紹介しました。その後、Claude や Codex などのコーディングエージェントを使った、より広範なテストにより、このスキルが、ユーザーの目標の達成と、推奨される MATLAB の関数や機能のより一貫した選択に役立つことがわかりました。このスキルは現在、MATLAB Agentic Toolkit で利用できます。
スキルはテキストファイルなので、チームでレビューし、バージョン管理の対象にして、独自の許容範囲、テスト、レポート、承認の関門に合わせて調整できます。実際の実装目標を設定して、Embedded AI スキルを試してみてください。スクリプトを確認し、モデル選択の妥当性を問い、測定結果の根拠をたどってみてください。エンジニアリングエージェントは、根拠と最終判断をそれぞれ本来あるべきところに委ねながら、専門家の実践を適用しやすくしてくれるはずです。
- Category:
- Artificial Intelligence,
- 機能と使い方,
- 生成AI


Comments
To leave a comment, please click here to sign in to your MathWorks Account or create a new one.